

Beiträge von audiobo
-
-

Es gibt noch andere kreative Lösungen, aber ist das wirklich noch kick out?
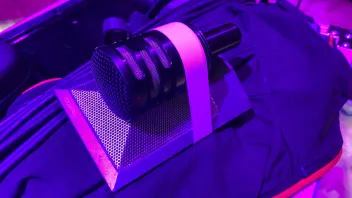
Nur wenn du das Audix um 180grad drehst 😉
-
Ja, klassisches Clipping sieht anders aus:
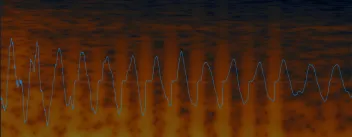
Wenn es ein elektrisches Problem gibt, könnte das evtl. auch in der Symmetrie zu finden sein (siehe Nulldurchgang beim Spannungsanstieg)
-
Und wenn du mal 600mV (oder direkt 2V, das entspräche dann den 145dB am Pro35) aus einer sicheren Quelle (Sinusgenerator) auf den Eingang deines Pultes/Stagebox gibst?
Ich meine mich zu erinnern, dass es beim X32 mal irgendeine schräge Situation mit Gain und Trim o.ä. gab. Im Ergebnis hatte man dann einen clippenden Eingang aber ohne entsprechende Anzeige am Pult.
-
uchrisu Kannst du ausschliessen, dass bei dir die Phantomspeisung vllt einen weg hat? (zu niedrige Spannung/in Summe nicht belastbar genug)
-
Alles andere würde ich sein lassen.
-

(Böse Spekulation: ist das ein aufgebohrtes 01v… in neuer Verpackung? Der Gedanke drängt sich mir gerade auf)
Wohl kaum - das 01V(96) hat mehr Inputkanäle. Ausserdem Stereolink, da gibt es das Problem mit den Fadern nicht. Dafür fehlen halt andere Dinge...
-
Hoppla

da du in deinem test in die kanäle überall das selbe signal einspeist, könnte es vielleicht sein, dass der Dugan die phasen- und pegelgleichheit an den eingängen erkennt und deshalb 6dB reduziert?
Jetzt muss ich doch tatsächlich an dieser Stelle einen Fehler meinerseits zugestehen:
Der Dugan reagiert sehr wohl auf Phasenunterschiede.
Ich habe vorgestern mal einen kurzen Test in einer QL1 gemacht. Pinknoise auf mehrere Inputs, Pgeldämpfung wie gewohnt -6dB/Verdopplung. Wenn man jedoch die Eingänge unterschiedlich verzögert und somit die Phasenlagen zueinander zufällig verschiebt, dann nimmt die Dämpfung tatsächlich ab.
Heute also noch einmal Gegencheck im Superrack:
Zum testen 2 Kanäle mit Sinus-Tongeneratoren, den ersten auf 1000Hz eingestellt, den zweiten auf 1001, 1005, 1010, 1015 und 1030Hz.
Dadurch ergibt sich also eine Phasenmodulation zwischen den Kanälen von 1, 5, 10, 15 und 30 Hz.
Hier ein paar kurze Videosequenzen:
1000 vs 1001 Hz.mov ; 1000 vs 1005 Hz.mov ; 1000 vs 1010 Hz.mov ; 1000 vs 1015 Hz.mov ; 1000 vs 1030 Hz.mov
Bei der 1Hz Modulation kann man klar sehen, wie die Pegelreduktion zwischen 0db und -6dB hin- und herfährt. Je schneller die Modulation, desto geringer die Pegelschwankung.
Dabei geht der Trend zu einer stärkeren Absenkung (im Mittel müssten es ja -3dB sein, tatsächlich kommt man in die Nähe von -6dB). Vermutlich sind die Regelzeiten so ausgelegt, dass die Absenkung (Attack) schneller ist als die Wiederanhebung (Release).
Und hier noch der Test mit je 2 unabhängigen Rauschgeneratoren:
-
Früher(tm) am LS9 war es gerne mal so, dass man im mehr oder weniger stressigen Konfigurationswahn 2 Kanäle gelinkt hat, den ersten davon langsam 1mm hochgezogen und der 2. Fader ist unwillkürlich von -oo auf +10dB gesprungen. (je nach Situation mit „interessanten“ Folgen 🙄). Teils auch spannend in Kombination mit Szenenspeicher.
Dagegen sind 12dB ja eine fast perfekte Angleichung 😉
-

Wie Liveprofessor, allerdings nur für Waves.
Wobei Liveprofessor auch Summierung kann. Superrack braucht für jeden Send einen eigenen Return.
-

wir betreiben seit einigen Jahren in gutes altes SKM100 an einem ew100 Empfänger.
Vielleicht sollte an dieser Stelle erst einmal geklärt werden wie alt die Geräte sind (G1, G2 G3?) und auf welche Frequenzen die Strecken eingestellt sind.
Danach Settings wie Squelch, Sendeleistung, Antennenverkabelung etc checken.
-

Ich habe in letzter Zeit so viele Konzerte und Festivals erlebt auf der die Bands auf der Digico SD 7 oder dem großen Avid-Pult richtig schlecht klangen bis hin zu katastrophal.
Kunststück: die SD7 ist ja schliesslich auch noch älter als das X32 😁 (duckundweg)
-
Im Endeffekt müssen wir gar nicht darüber diskutieren, wie das theoretische und/oder praktische Idealregelverhalten ausschaut. Es sei denn ihr wollt daraus ein Forenprojekt machen: „Die Entwicklung des perfekten Automixers“
Mir fehlt einfach Transparenz seitens der Hersteller bezüglich des Regelverhaltens ihrer Algorithmen, damit wir unsere Arbeitsweise entsprechend anpassen oder das uns am meisten zusagende Gerät auswählen können. (Ähnlich wäre es, wenn es z.B. nur Kompressoren mit verschiedenen fixen Ratios gäbe.)
Daher der Versuch an dieser Stelle mal eine Übersicht zu gewinnen.
-
Wie ist das System denn einzuschätzen? Kann das Stadtfest mit 2000 Leuten vor der Bühne?
Man findet quasi nichts dazu.
Da das System bei 4 Elementen/Seite schon 80Grad vertikal macht bezweifle ich das.
-

Oder kann der DSP intern "nur" 4 Kanäle verwalten und man hat die Wahl aus den 8 AES-Kanälen ?
4 x Lake Mesa modules or 2 x Lake Contour modules for optimized system or loudspeaker control
…
Two LM 44 units may be stacked and linked to function as an 8 × 8 processor.
-
Ich glaube, er meinte nicht, dass es im Automixer drin ist, sondern dass man das so als zielführendes Vorgehen in der Situation selbst implementiert.
Exakt.
Wobei: es gibt als VST-Plugin noch den WT Automixer, der hat einen (bei Bedarf aktivierbaren) Leveler. Habe ich aber noch nicht ausprobieren können.
-
Nein mit Summenkompression meine ich Summenkompression - Wenn geredet wird, kommt mehr Input und um den Sendepegel bei Kopf-hin-und-her-Drehern und Schunkelonkeln konstant zu halten nutzt man einen Kompressor. Dieser jedoch sorgt wiederum dafür, dass in Sprechpausen mehr Hintergrundgeräusch zu hören ist.
-
Hallo Wolfgang
Ich habe mir schon gedacht, dass dieser Einwand kommt...

Dazu eine Anmerkung: Ich habe versucht möglichst keine Wertung vorzunehmen, ob 3dB oder 6dB Reduktion/Verdopplung jetzt besser ist. Allerdings ist das ziemlich schwierig, da der Dugan nun mal so etwas wie der Platzhirsch unter den Automixern ist und mittlerweile seit Jahren in der Branche anerkannte Ergebnisse abliefert.
da du in deinem test in die kanäle überall das selbe signal einspeist, könnte es vielleicht sein, dass der Dugan die phasen- und pegelgleichheit an den eingängen erkennt und deshalb 6dB reduziert?
Diesen "Test" habe ich ja nur auf die Schnelle am SQ6 durchgeführt - das Verhalten vom Dugan kenne ich zur Genüge, dieser hat übrigens auch eine Skala an seiner Gain-Anzeige - daher weiss ich, dass ihm irgendwelche Phasenkohärenz ziemlich egal ist Korrektur - dem ist nicht so, allerdings kann u.U. aufgrund der Regelzeiten der Eindruck entstehen.
Tatsächlich ist es so, dass die Summe aus nicht kohärenten, gleich lauten Signalen leiser ist als ein einzelner, offener Kanal. Aber das kann ja durchaus ein gewünschtes Verhalten sein, zumal nicht selten noch irgendeine Summenkompression mit im Spiel ist.
Der andere Punkt ist das gegenseitige "Ducking". Mir war es als erstes an der SQ5 damals aufgefallen, als wir einen reinen Streamingjob mit externem Teilnehmer produziert haben - dieser wurde im Raum über Lautsprecher hörbar gemacht. Nach meiner Erfahrung hätte in der Konstellation mit dem Dugan der Automix für die Dialogsituation ausgereicht, hier musste ich nun einen zusätzlichen Ducker einrichten. Auch sind die Mikrofone der aktuell nicht redenden Teilnehmer deutlicher hörbar als ich es sonst gewohnt bin.
In einer reinen Beschallungssituation, vermischt mit Direktklang und Saalakustik geht das eher schon mal unter, im Stream merkt man das halt schneller.
-

…mitteilen um welche der ~ 50 verschiedenen Modelle es sich handelt?
ProAV2
-

Die dLive hat 2 AMM modi:
- NOM, verwendet gating und eine fixe Absenkung. (Ich vermute die SQ verwendet diesen Modus)
- D-classic, "constant gain sharing" Algorithmus. Ähnelt aus meiner Sicht dann mehr dem Original.
Dem Manual nach ist es der D-Classic-Algorithmus.
