

Gerrit42 bist du nicht der U.S.L.A.H.A.-Gerrit?
In dem Fall Jungs, Entwarnung. ?
Gerrit42 bist du nicht der U.S.L.A.H.A.-Gerrit?
In dem Fall Jungs, Entwarnung. ?

 Alles anzeigen
So, jetzt habe ich mal gespielt:
Setup: SATlive 1.70.46 und mein virtueller Lautsprechersimulator.
Messung im IR-Modul: MIR (-> Dual -FFT mit Resultat Impulsantwort), Länge 512k (ca 11s Messdauer). Dann STI Berechnung mit dem eingebauten STI Tool in SATlive.
Dann habe ich zusätzlich zum simulierten Lautsprecher noch pink noise eingespielt. Aus dem 'Lautsprecher' kommt auch pink - noise, allerdings mit der Impulsantwort eines Topteils 'gefalltet'. Die Pegelverhältnisse sind daher nicht 100% korrekt, aber wir sind ja noch in der Testphase:
Noise off: STI: 0.99
Noise -20dB: STI: 0,87
Noise -15dB: STI: 0,67
Noise -10dB: STI: 0.56
Noise -5dB: STI: 0,39
Noise 0dB: STI: 0.22
Folgerung: Die Methode liefert ein vom S/N abhängigen Indikator, den man Überwachen könnte.
Ich habe die Messung von Hand durchgeführt, mit dem entsprechenden Equipment wäre 4 Messungen / Minute möglich (wobei noch länger / gemittelt möglich wäre, und man auch das Thema Pause noch beachten müsste). Man bräuchte halt beide Signale (das was der Speaker bekommt, und dass was das Messmikro bekommt).
Wenn 0dB bedeutet, dass Störgeräusch und Testsignal gleich laut sind, dann muss da aber noch ein Fehler vorliegen. Meines Wissens nach bedeutet (quasi als Faustformel) gleicher Pegel = STI 0.5
Auch zu erkennen in diesem Dokument (Seite 16):
http://www.ifaa-akustik.de/files/zvei-ens…18-a-goertz.pdf
Wobei das auch nur für kleine und mittlere Pegel gilt, wie auf Seite 18 zu sehen.
Aber coole Aktion...
So, nach einigem Mitlesen mein Senf dazu (wollte es nicht am Handy reintippsen):

ich habe anfangs nur an einen Ziel-Amplitudenfrequenzgang gedacht. Den könnte man mittels Multiband-Expandern zaubern. Dazu nen DSP ala Yamaha DME/MRX, bss o.ä. mit 3-4 Expandernwegen, die von einem vor Ort aufgestellten Messmikro getriggert werden. Je nach Besucheranzahl schrauben die Expander einen bestimmten Frequenz-Bereich nach.
Also quasi ein Multiband-Vocal-Rider? Das hätte (ohne weitere konzeptionelle "Feinheiten") wiederum den Nachteil dass das System auf sich selber reagiert.
(Lautes Regelsignal öffnet Expander -> noch lauteres Regelsignal öffnet Expander noch mehr -> usw., bis das Maximum erreicht ist)
Beim STI werden ja bestimmte Frequenzbänder (ich meine bewertet. Daraus lässt sich ja ein "sprachverständlicher" Zielfrequenzgang ableiten.
Jein. Es geht nicht einfach um Frequenzgang, sondern darum, ob in den jeweiligen Frequenzbändern die Modulation der menschlichen Stimme genügend deutlich übertragen wird. Einflussfaktoren sind neben Klirrfaktor und Bandbegrenzung vor allem Reflexionen/Hall und Störgeräusche, aber auch Endlautstärke.
Da ja aber auch STI angesprochen wurde, kommt für mich die Frage auf, wie ich Live den Störpegel messe.
Genau darum ging es mir ja.
Da ja aber auch STI angesprochen wurde, kommt für mich die Frage auf, wie ich Live den Störpegel messe. Laut Normen wird beim STI gemessen, und dann darf ein Störpegel miteingerechnet werden. Den Pegel gibts als Vorgabe oder man nimmt ihn realistisch selber an, aber welches Spektrum dafür wählt man?
nach Bewertungsfilter A, wenn ich mich recht erinnere  .
Das mit dem reinrechnen hat einfach den Hintergrund, dass man die Messungen i.dR. nicht bei vollem Haus macht. (Wer möchte schon freiwillig ständig irgendwelche Sinussweeps oder STIPA-Signale ertragen?)
Auch müsste der Hintergrundlärm konstant sein bzw. eine STIPA-Messung kann z.B. nicht mit impulshaltigen Störgeräuschen umgehen.
Aber grundsätzlich kannst du den STI bei real vorhandenem Störgeräusch messen. Bei Tomys und Christians Ansatz wäre halt die Frage offen, wie gut das wohl über eine Kohärenzmessung mit Programmton anstelle konkreter, optimierter Testsignale funktioniert.

Wenn ich mir das so vorstelle, wäre für mich auch die Frage, ob es dann nicht, wie stepu bereits beschreibt, sinnvoller ist, statt "Ton-Mess-Regel-Dingens" von den Plätzen, die vom Pultplatz aus nicht beurteilbar sind, ein Kamerabild zu haben (muss ja keine dolle Qualität haben), welches einem beurteilen lässt, was da gerade zu beschallen ist und mit welchen "Störungen" dort zu rechnen ist?
hmm, da fallen mir spontan einige Dinge ein, die man mit einem Kamerabild (insbesondere wenn es von eher nicht so doller Qualität ist) nicht unbedingt einschätzen kann:
- vereinzelte laute Lärmquellen (Druckluftsirenen, Vuvuzelas, Heilkopter, etc.) Und umgekehrt können auch sehr viele Menschen u.U. erstaunlich ruhig sein.
- wetterbedingte Einflüsse auf die Beschallung (Wind)
- Beeinträchtigung der Beschallungsanlage, z.B. aufgrund Fremdeinwirkung (abstecken, wegdrehen), Defekt, etc.

Vollig anderer Ansatz, wir hören ja Sachen. Wie wäre es mit Audio-Feeds aus den Zonen, in die wir einfach reinhören, um zu beurteilen, ob die Beschallung passt?
Beim Hören könnte ich noch nicht anhand von Mess/Atmo Mikros nachregeln,
da muss ich noch lernen.
Ist noch interessant, ich mache das oft, wenn der FoH im Off in einer Kabine o.ä. aufgebaut ist. Die Wahl des Mikrofontyps macht da noch einiges aus. Bei einem Druckempfänger-Trennkörpersystem wie einem Kugelflächenmikrofon z.B. ist die Wiedergabe über einen Kopfhörer wirklich verblüffend echt.
Wenn es über einen Lautsprecher wiedergegeben werden soll, lande ich idR. eher bei Grenzflächen oder Richtrohr.
Bei D&B wird ja die allseits bekannte „fette RockKurve“ im Messkurs propagiert
(Bass lauter, Mitten glatt von viellecht 100-10000Hz, dann ein leichter Höhenabfall).
Für Livemusik mg ich das auch, aber wie muss die Kurve für zB Sprache aussehen?
Flat ist im Prinzip ein guter Anfang (ob PA direkt oder über die Vocal-Subgruppe ist ja egal). Hängt aber letzten Endes nicht nur vom Amplituden- sondern auch vom Nachhallfrequenzgang ab.
Beispiel vom Freitag: VA in einer SEHR gut klingenden Location (RT60 gleichmässig von 100Hz bis ca. 6kHz bei knapp 1s, fast keine parallelen Flächen), Frequenzgang nach dem messen über den Vocalbus linear gezogen - DPA 4066 + Shure KSM9, jeweils mit Hi- und LoCut (10kHz/150Hz), Dynamics, sonst nichts.
Bei gefühlten 1000 Veranstaltungen in irgendwelchen Betonbunkern hingegen wird regelmässig untenrum entschlackt was das Zeug hält, vor allem bei den Kugeln.
Falls das mit dem Gainsharing kein Problem ist - das Splitten der Eingänge über die x-Dante-Karte funzt ziemlich gut mit fast keiner Latenz (wenn über die 8er-Blöcke im Routingmenü). Wichtig ist einfach, dass im x32 die Karte als Clock-Master definiert wird. Ach ja, und: 48kHz only!
Naja, es sind immer noch 3dB Differenz, die 3m vor dem Lautsprecher eben nicht auftreten. Genauso wenig wie zusätzliche wetterbedingte Differenzen zwischen Zeitpunkt "Referenzmessung" und "Show".
Ich habe gerade das Gefühl, dass ich meinen Gedankengang vllt diesbezüglich noch nicht klar genug dargelegt habe...
Ich formuliere es einmal als offene Frage:
Können wir davon ausgehen, dass der Korrektur-Offset, den wir bei der Referenzpegelmessung für das Messmikrofon nahe der Lautsprecher ermitteln, während der Show noch stimmt?
Wenn nein, welche Faktoren spielen eine Rolle und wie gross kann diese Differenz werden?
Und: Kann diese Differenz gross genug werden, um einem den Spass an der Show zu verderben, wenn die Anzeige mit dem vorab eingestellten Korrekturfaktor zu sehr von der tatsächlichen Endlautstärke am Referenzort im Publikumsbereich abweicht.
Andernorts (im Zuge der SLV-Revidierung) gab es z.B. ja schon das Thema des Einsatzes von Schultermikros bei Amtspersonal. Während quasi nebenan auf geeichtes Klasse1-Equipment verwiesen wird. 
In der Schweiz mgmaudio.
Für DE lässt es sich hier herausfinden:
https://www.midasconsoles.com/brand/midas/store-finder?type=STORE&division=ENTE&isoCode=DE#googtrans(en|en)
Das Constellation System im „Round Room“ des neuen KI-NEO-Gebäudes umfasst insgesamt 130 MM-4XP Miniaturlautsprecher
53 kardioide Miniatur Mikrofone und acht Shotgun Mikrofone
Definitiv anderer Ansatz - da werden vermutlich "einfach" über eine Matrix zu den zum Mikrofon entfernten Positionen verstärkt, vermutlich noch mit Hilfe eines Automatikmischers, damit sich nicht alles gegenseitig aufschaukelt.
Hmm ja, allerdings haben beide Ansätze so ihre Schwierigkeiten mit akustisch anspruchsvollen Umgebungen. Gerade letzteres ist ja eher auf die Verbauung von Mikrofon und Lautsprecher auf engstem Raum optimiert.
Wo liegen die QLX-D/ULX-D noch mal? Ich meine, es waren 2,9ms. Im HD-Modus mehr, wenn ich nicht ganz falsch liege.

was bedeutet denn dort der "HD Modus"?
So langsam kommt hier Fahrt auf 
- MIR Messung mit einigen Mittelungen (Dual-FFT mit IR als Resultat)
Wenn ich das Prinzip der Dual-FFT richtig verstanden habe, hätte dies den Nachteil, dass man schlecht bandbreitenoptimiert und/oder zeitvariant übertragen kann.
Einerseits braucht es ja ein kontinuierliches Audiosignal, andererseits darf man, wenn ich mich recht erinnere, für STI (vllt auch nur STIPA, allerdings denke ich dass das für alle breitbandigen Signale gilt) innerhalb des Messsystems nicht datenreduziert übertragen.
Ich denke gerade an ein Stadion, wo Simulationen vor dem Hintergrund aktiver Fans gerne mal völlig versagen und die Sprachverständlichkeit extrem variiert, je nach Fan-Aktivitäten.
Jup. Zum Beispiel. Auch in der ein oder anderen Gerätschaft des öffentlichen Nah- und Fernverkehr wäre eine durchgängige akustische Überprüfung der Durchsagequalität wohl nicht verkehrt. 
hier würde dann vielleicht eine adaptive pegelanpassung helfen.
Daran habe ich auch schon ein paar mal gedacht. Allerdings wirft sich bei mir immer die Frage auf wie das System verhindert, dass es auf sich selber reagiert.
Klar, für kurze Durchsagen kann man einfach den Zeitraum davor messen, bei kontinuierlichem Programmton wird dies allerdings schwieriger.
Ich habe mir eben mal den Spass gegönnt und nach Patenten in dem Bereich gesucht, da gibt es schon ein paar. U.a. taucht da der Gedanke nach Formantenerkennung auf. Leider werden aber einige wohl auch nicht weiterverfolgt.
Ein weiterer Ansatz könnte vllt. sein, dass das System mit Hilfe von Richtungserkennung arbeitet - Beispiele für Ambisonic-Mikrofone o.ä. gibt es ja mittlerweile auch in fast jeder Preisklasse. Hilft uns ja immerhin auch, um Geräuschquellen zu separieren und fokussieren.
Soviel zum theoretischen Gedankentennis. Aber ein konkretes Produkt (zumindest abseits der TU-Highend-Bereiche) für eine solche Anwendung scheint demnach noch nicht unterwegs zu sein...?
Wenn ich das hier richtig mitgelesen habe, unterhaltet ihr euch über tatsächliche analoge und digitale Signalpegel Max/Peak und Referenz.
Im Dokument von EBS geht es im Abschnitt dBFS vs VU praktisch AUSSCHLIESSLICH um Aussteuerungsanzeigen und ihr unterschiedliches Zeitverhalten. Es ist vllt. gerade für unseren Befarf. etwas unglücklich formuliert.
Im Grunde ist es aber auch egal - am Ende orientiert man sich daran wie die relevanten Übergabepunkte ausgelegt sind (digital/analog), welche Norm am Platz vorherrscht, und der Rest drumherum wird angepasst.
Bei Endstufen/Controllern etc. würde ich meinen Übergabepunkt grundsätzlich Peak-to-Peak anpassen. Passiert auf digitaler Ebene genau so und verschwendet keinen Headroom. Bei den meisten ernstzunehmenden Pro-Audio-Produkten ist das eh der Fall, da hat es vllt mal 2dB mehr oder weniger.
hmm, mal so, mal anders
Was (neben Gesang) beim Pitchshifting gar nicht geht ist, wenn man gleichzeitig noch die echte Stimme von der Bühne hört. Da schlägt das Gehirn solche Purzelbäume, dass man an Sprachverständlichkeit nichts dazu gewonnen hat - ähnlich wie bei zu grossen Latenzen, die allerdings manchmal leider nicht mehr in unserem Einflussbereich liegen (z.B. Position weit vor der Bühne/Beschallung).

Also, bei einer sachgerechten Messung nach DIN 15905-5 ist der maßgebliche Immissionsort der lauteste Punkt im Publikumsbereich (also üblicherweise sehr im Direktschallfeld der Box), und der Mikrofonort ist noch mal deutlich näher an der Box (damit die Korrekturwerte negativ werden).
Da sollten Änderungen der Raumakustik (also z.B. durch Publikum ja/nein) überhaupt keine Rolle spielen. Zumal ja ein Ein-Zahl-Wert über den gesamten Frequenzbereich erfasst wird. Und im Messverfahren ganz andere Ungenauigkeiten stecken.
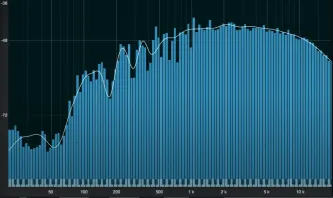
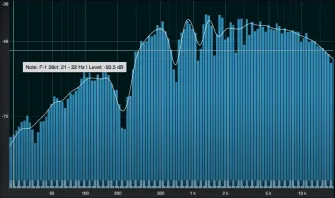
Auf den konkreten Fall bezogen: Ich habe es jetzt einmal durchgerechnet/simuliert - tatsächlich habe ich den Korrelationsgrad der Reflexion bei 40m Entfernung (bei - bequemerweise fixen - 9m virtueller Höhe der Schallquelle und 1,7m "Messhöhe") höher eingeschätzt als er tatsächlich ist:
Direktsignal:
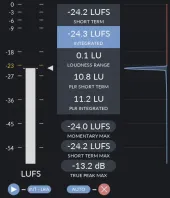
Direkt + Reflexion bei 5m Entfernung (Dämpfung durch 25% Weglängendifferenz: 2,5dB):
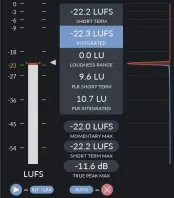
Direkt + Reflexion bei 40m Entfernung (Dämpfung durch 1,8% Weglängendifferenz: 0,16dB):
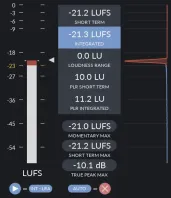
Macht also mit A-Bewertung eine maximale Pegeldifferenz (mit/ohne Reflexion) von 3dB, die THEORETISCH bei der (bei leerem Platz durchgeführten) Korrekturmessung zu unseren Ungunsten ausfallen könnte.
(Publikum absorbiert 3dB, FoH gibt entsprechend 3dB mehr Gas - im Publikumsbereich sind jetzt 100dBA, während das Messmikrofon im Nahbereich des PA allerdings schon korrigierte 103dBA anzeigt - theoretisch.)
Dass ich den Unterschied subjektiv noch stärker wahrgenommen habe (Hintergrund DJ + Moderation) dürfte an den reflexionsverursachten Peaks liegen, die dann tatsächlich bei je knapp +6dB liegen:
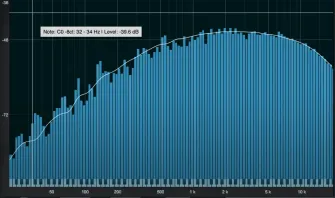
Deswegen mitteln wir ja auch unsere Messergebnisse, um wenigstens die Klangbeeinflussung durch die Reflexionen entsprechend statistisch zu verteilen.
Mir ist übrigens klar, dass PA-Design, sonstige akustische Einflüsse und Programmart ebenfalls Einfluss auf das Ergebnis haben - das oben simulierte gilt somit nur auf ebenen Freiluftgeländen mit schallhartem Untergrund und angenommener perfekt gleichmässiger Schallausbreitung.
Da sich unterschiedliche Einflüsse aber nicht zwangsläufig gegenseitig ausgleichen, finde ich eine Beschäftigung mit der Thematik durchaus legitim.
Und dass es mir bis jetzt noch nie so aufgefallen ist, hat schlicht damit zu tun, dass sich meine Systemjobs (abseits von reinen Delaymessungen) eher auf meist bestuhlte Indoorveranstaltungen und/oder Umgebungen mit Rängen/Tribühnen beschränkt haben.
als zwischenlösung für dieses abhörproblem könnte man auch helfer mit walkie-talkie ausstatten und in die fraglichen bereiche setzen.
Das klingt nach einer prinzipiell schönen Lösung. Leider zeigt die (also meine persönliche) Erfahrung, dass diese Leute bei so langen Veranstaltungen aus diversen Gründen meist nicht da sind, wenn man darauf angewiesen ist.
Helfer bei den grossen Sportevents z.B. kommen hier übrigens sehr oft von dieser Truppe:
https://de.wikipedia.org/wiki/Zivilschutz_(Schweiz)
Die werden dann auch schon mal plötzlich abkommandiert.
Pegelmessung und Korrekturfaktoren klingt nach DIN 15905-5...
Wo ist Dein Messmikrofon während der Veranstaltung?
Mein eigenes ist dann meist im Toolcase oder, je nach Job sogar zu Hause - btw. gilt ja hier die SLV.
Ich versuche einfach ein wenig voraus zu denken und im besten Falle meinen Projektleitern irgendwann bei Bedarf konkrete Lösungsvorschläge anbieten zu können. Selbst wenn es nicht in meinem direkten Verantwortungsbereich liegt.
Aber tatsächlich würden mich da - gerade zu den oben von dir zitierten Zeilen - deine Meinung und deine Erfahrung interessieren, also welche Abweichen tatsächlich auftreten können.
Ansonsten könnte man auch ein QS System nehmen, dass auf Abweichungen von der Sollvorgabe reagiert.
Das trifft es eigentlich ganz gut.

was wollt Ihr da denn dort messen und warum?
Welche technische Grösse sagt denn überhaupt aus was sich wie verändert? Kann man das überhaupt mit Livesignal als stimulus messen?
Mir geht es vor allem darum, z.B. bei langen Mehrtagesveranstaltungen in verschiedenen Zonen (teils Main-PA bis 100m entfernt, teils Delays über PointSources, teils VIP-Bereiche mit Böxli auf Stativ) einerseits die Sprachverständlichkeit sicherzustellen, andererseits unnötig hohe Lautstärken zu vermeiden.
Das Ganze bei sich stetig verändernden Personfluss und Feierlaune in verschiedenen Bereichen.
Und wenn man dann das Ergebnis hat , was macht man dann damit?
Hängt dann einer während des Gigs die Pa um?
Zonen nachregeln, evtl. innerhalb des Arrays Pegel geringfügig anpassen, also alles was technisch sinnvoll und überschaubar machbar ist.
Habe mal den Titel angepasst. Der war irgendwie suboptimal, da der Gedanke jetzt am Wochenende während eines verhältnismässig kleinen Jöbli aufkam, bei welchem ich als FoHler zwischendurch auch mal auf den Platz konnte.
Wird dann aber für einen, der auch noch das Pult bedient schon wieder etwas viel.
Davon war keine Rede.
Das System muss in der Variante gar nicht unterscheiden. Es braucht lediglich Lautstärkeverläufe darstellen und evtl. bei Abweichungen einen Fokus nach dem Motto „schau mal, da drüben ist was anders als bei den anderen Positionen“ zu generieren . z.B. wenn ein Differenz-Schwellwert von sagen wir 3dB überschritten wird.
Natürlich könnte man erwägen das Ganze um Spektal- und Hüllkurvenvergleiche zu erweitern, aber so weit wollte ich gar nicht gehen.
Die Veränderung, die Du wahrscheinlich am liebsten voraus kalkulieren möchtest, ist ja komplex ...
Hmm, kalkulieren klingt wie Wettervorhersage - ich glaube ein Messsystem, welches den aktuellen IST-Zustand repräsentiert ist da als Hilfsmittel überzeugender.
Mal angenommen (rein hypothetisch), ich hätte verteilte Messpunkte auf dem Areal zur Verfügung, die mir regelmässig einen 10sLEQ durchgeben, schön nebeneinander auf einem Bildschirm inkl. Verlaufsanzeige, dann hätte ich eventuelle Ausreisser im Blick (evtl. mit PopUp-Meldung) und könnte bei Bedarf den/die Kollegen mit dem Funkgerät in die passende Richtung schicken, um sich das mal anzuschauen. Anstatt darauf zu vertrauen, dass er/sie nach den bisherigen 5-6 Stunden VA-Verlauf gerade zufällig genau in der Ecke herumstreunert.
Oder möglicherweise gar in einen Echtzeit-Mithör-Modus wechseln, ob das einfach irgendein Lärm ist und wenn ja, ob die Beschallung noch verständlich ist.
Da bin ich weder bei KI noch bei Glaskugel angelangt. Das sind Aktionen, die in Teilen schon von einfachen Babyphone- oder Schallpegelmessapps für Mobiltelefone geliefert werden.
Jetzt fehlt da nur der grosse Kochtopf und die Pro-Verpackung.
Mein Kontakt zu grossen Touring- und Festival-Dienstleistern ist ja eher gering; allerdings habe ich schon ein paar mal erlebt, dass diese im Bereich mobiler Infrastruktur etc. in einigen Dingen dann doch erheblich weiter sind als die grösseren "Wir machen alles, aber insbesondere Corporate"-Buden. U.a. deswegen habe ich das hier auch angerissen.
Dass der verlinkte Artikel etwas schön färbend formuliert ist, habe ich gleichwohl bemerkt, wollte aber die Möglichkeit, dass ich evtl. auch einfach etwas verpasst habe, nicht ausschliessen.
Und ich weiss sehr wohl,. dass, wenn vorne alles glänzt, hinten noch gesägt wird, während die Show auf dem gerade eingetroffenen Ersatzpult läuft, weil das ursprünglich georderte Hightech-Teil aufgrund eines korrupten Firmware-Updatefile o.ä. den Dienst quittiert hat.
Das macht uns ja vor Ort als Profis aus - zurück zu "from the scratch" wenn es nicht anders geht. Ist aber m.E.n. kein Grund nicht offen für neue Varianten zu sein.
ich versteh das so das du wissen willst was wir da machen...
wenn du nur technische Lösungen wolltest dann musst du auch danach fragen und nicht allgemein fragen
Ja richtig, allerdings war die Variante eigentlich schon in Beitrag Nr. 3 abgeharkt.